データサイエンス実践 Ch6 機械学習の枠組みと決定木
資料
人工知能の歴史
この講義は, 文部科学省の定める「数理・データサイエンス・AI 教育プログラム」の一環ですが, 統計, 機械学習, AI, データサイエンスなどの違いはそれほどはっきりしていません. このことは第2章でも扱いました.
AI は Artificial Intelligence (人工知能) の略語です. 世の中では, 様々なものが AI と呼ばれており,
- Automated Instruments (自動化されたなにか)
- Anything IT-related (IT に関連したなんでも)
などの AI という用語の濫用を揶揄する言葉もあります.
AI が研究の課題として最初に提起された 1956 年のダートマス会議の提案書では AI の研究を以下のように定義しています.
この研究は, 学習のあらゆる側面, あるいは知能のその他の特徴は原則として, 機械がそれをシミュレートできるほど正確に記述できるという推測に基づいて進められる.
機械に言語を使わせ, 抽象や概念を形成させ, 現在人間にしかできないような種類の問題を解決させ, 自らを向上させる方法を見つける試みがなされる.
注意深く選ばれた科学者たちがひと夏の間, 一緒にこの問題に取り組めば, これらの問題のひとつやふたつに大きな進歩がもたらされると, 私たちは考えている.
このように当初の AI の定義によれば, AI は,
- 抽象や概念を形成する
- 現在人間にしかできないような種類の問題を解決し
- 自らを向上させる方法を見つける
ことができる機械であるとされています.
当初の AI 研究では, 特に 2 番目の問題解決に焦点を当てていました.
例えば, ノーベル経済学賞を受賞した, ハーバート・A・サイモンらが人間の問題解決の手法を模倣して作った最初期の AI であるGPS (General Problem Solver) 一般問題解決器が有名です.
GPS では, 「問題」を「現在と目標との差異」と定義して, 目標と現状の差を小さな差に分解し, それを順に解消していけば, おおよそすべての問題を解決できるとしました.
- 目標: 対象 A を対象 B に変換せよ
- 対象 A と対象 B を照合し差 D を見つけよ
- サブゴール D を縮小せよ
- サブゴール A’を B に変換せよ
- 目標: 対象 A と対象 B との間の差 D を縮小せよ
- D を縮小するのに適した作用子 Q を探せ
- 実行可能かどうかテストせよ
- サブゴール A に Q を適用して A’を作る
- 目標: 対象 A に作用子 Q を適用せよ
- Q の条件を A と照合し差を見つけよ
- サブゴール D を縮小せよ
- サブゴール A’に Q を適用せよ
(cf. Newell, Allen, and Herbert A. Simon: “GPS, A Program that Simulates Human Thought,”Lernende Automaten, Munchen (R. Oldenbourg, ed.) (1961), Reprinted in Computers and Thought(Feigenbaum and Feldman, eds.) (1963) )
しかしこの手法は, 目標と現状を明確に記述でき, 両者の差を測ることができ, その差を埋める手段が定まっている問題 (チェスや迷路など) にしか適用できませんでした.
その他にも, 基本的には当時の AI は, 「問題の解決の仕方」を人間が定義して, それを直接的にプログラムするという手法で開発されています.
その後, AI の発展は以下の年表のような歴史を辿ります.
| AI ブーム | 内容 |
|---|---|
| 第1次 AI ブーム | • 1956年: ダートマス会議でスタート • 一般問題解決器 (現状と目標との差異) • 一般的な問題解決の手順を, 人間が条件分岐などで直接プログラム • 1960年代はじめ: 機械翻訳の失敗で収束 |
| 第2次 AI ブーム | • 1980年代はじめ: エキスパートシステム, 機械翻訳 • 知識の活用を目指す (辞書などの知識をデータベースとして整理して利用) • 1980年代はじめ: 第5世代コンピュータープロジェクト • 1990年代はじめ: 知識導入・商業性で収束 |
| 第3次 AI ブーム | • 2010年から現在: ANN (Artificial Neural Network) の復活 • 検索エンジン研究で発達 • ゲームでの成功 (チェス, 将棋, 囲碁) • パターン認識での成功例 (音声解析, 画像解析など) |
| 第4次 AI ブーム | • 現在: 生成系 AI • 画像・動画・音声 |
(cf. 寺野隆雄, 生成系AIの歴史・原理・現状, 千葉商科大学 2023年 第1回FD 「生成系AIに関するFD」 ,2023/05/18)
この歴史のすべては扱いませんが, 第3次以降の AI ブームは, ダートマス会議の提案にある「3. 自らを向上させる方法を見つける」に関わる技術の発展によるものです.
本章では, まず大規模言語モデルの歴史と, 大規模言語モデルがあっても機械学習が使われる理由を確かめます. 次に, この「自らを向上させる」機械である機械学習の概要と, 教師あり学習の手法の 1 つである決定木, 分類の評価の方法を扱います. 第7章以降では, 機械学習の手法として, クラスタリング, ニューラルネットワーク, 自然言語処理, 画像認識を扱います.
大規模言語モデルの歴史
上の年表で第 4 次 AI ブームに挙げた生成系 AI のうち, 文章を扱うものの中心にあるのが大規模言語モデル (LLM; Large Language Model) です. LLM は, 大量の文章から言葉の並びの出やすさを学習したニューラルネットワークで, 文章の続きを 1 トークンずつ作ることで, 質問への回答, 要約, 翻訳, プログラムの作成などを行います. 普及までの流れは次のとおりです.
| 年 | 出来事 |
|---|---|
| 2017 | Google の研究者らが Transformer を提案する (第8章). 文章の全体を並列に処理できるので, 大量のデータで大きなモデルを学習しやすい |
| 2018 | Google が BERT, OpenAI が GPT を発表する. 大量の文章で事前学習したモデルに, 課題ごとの追加学習をする方法が自然言語処理で広がる (第9章) |
| 2020 | OpenAI が GPT-3 を発表する. パラメータの数は 1750 億で, 課題の例を数個, 入力 (プロンプト) に書くだけで課題を解けることを示した |
| 2022 | 11 月に OpenAI が ChatGPT を公開する. 指示に従うための追加学習をしたモデルを対話の形で誰でも使えるようにし, 利用者が急速に増えた |
その後は多くの企業や研究機関が同様のモデルを公開し, 公開されたモデルを自分の計算機で動かすこともできるようになりました. 事前学習, 指示に従うための追加学習, 生成の 3 段階の仕組みは, 第9章で扱います.
大規模言語モデルと機械学習の用途の違い
決定木, 回帰, 分類器などの機械学習は, 課題ごとに入力と出力の形が決まっている点で, LLM と用途が分かれます.
| 決定木, 回帰, 分類器 | LLM | |
|---|---|---|
| 入力 | 課題ごとに決めた説明変数 (表形式のデータなど) | 自然言語の文章 (指示と資料) |
| 出力 | あらかじめ決めた形式の値 (クラス, 確率, 数値) | 文章 (形式は指示で変わる) |
| 学習 | 課題ごとに, 正解付きのデータで学習する | 大量の文章で事前学習したモデルを, 多くの課題に使い回す |
| 向く用途 | 会員の退会予測のように, 決まった項目から決まった値を大量に求める | 問い合わせへの返信の下書き, 要約, 翻訳のように, 文章を作る |
LLM に文章の感情の分類を頼むこともでき, 同じ課題を第9章の BERT のファインチューニングで解くこともできます. どちらでも解ける課題での使い分けは, 次の節で扱う費用, 決定性, 説明可能性で決まります.
機械学習がまだ使われる理由
LLM で多くの課題を解けるようになった後も, 決定木や回帰のような機械学習は使われ続けています. 計算の費用と速さ, 同じ入力に同じ出力を返す性質, 予測の根拠を読めることの 3 点で, 小さなモデルのほうが向く課題があるからです.
計算の費用と応答の速さ
LLM は数十億個以上のパラメータをもち, 学習にも推論にも GPU などの大きな計算資源を使います. LLM の API は一般に, 処理したトークンの数に応じて料金がかかり, 出力は 1 トークンずつ作るので, 回答が長いほど時間がかかります. 本章の決定木は, 深さ 2 なら予測が 2 回の比較で終わります. 退会予測のように, 項目の決まった表から 1 件ずつ値を求め, それを毎日何万件も繰り返す課題では, 小さなモデルで足りることが多く, 1 件あたりの費用と時間の差が件数に比例して積み上がります.
決定性: 同じ入力に同じ出力を返す性質
学習を終えた決定木や第5章の線形回帰は, 分岐の条件や係数が固定されているので, 同じ入力には毎回同じ出力を返します. この性質を決定性といいます. 決定性があれば結果を再現でき, 判定を後から検査しやすくなります.
LLM では, 第9章で扱った温度を下げて確率が最大のトークンを毎回選ぶ設定にしても, 同じ出力が返るとは限りません. Horace He らの記事 (Defeating Nondeterminism in LLM Inference, Thinking Machines Lab, 2025 年 9 月 10 日) は, オープンな LLM の 1 つ (Qwen3-235B-A22B-Instruct-2507) に同じ質問を温度 0 で 1000 回尋ねたところ, 1000 トークンの回答が 80 通りに分かれ, 最も多い回答でも 78 回だったと報告しています. 原因として記事が挙げるのは, サーバの負荷によって, 一緒に処理される要求の数 (バッチの大きさ) が変わることです. 計算の実装がバッチの大きさに応じて足し算の順序を変えると, 浮動小数点の丸めのために結果がわずかに違ってきます. その差で確率の近いトークンの順位が入れ替わると, 以降の文が変わります. 利用者は他の利用者の要求の数を制御できないので, 利用者から見ると出力が決まらないことになります. 同じ記事は, 計算をバッチの大きさに依存しない実装に替えると 1000 回とも同じ回答になったと報告していますが, その分処理に時間がかかります.
予測の根拠を読めること
決定木では, 予測に使われた分岐の条件がそのまま根拠になります (決定木分析). LLM は理由を文章で答えられますが, その文章が, 実際に答えを導いた計算を表しているとは限りません.
出力の形を限った新しいモデル: TypeSafe の Jev
LLM とは別に, 文章を生成せず, 決まった形の判断だけを返すモデルも出てきました. TypeSafe 社の Jev は, 同社が System One モデルと呼ぶ種類の最初のモデルです. 公式の文書 (System One) によると, Jev は LLM と同じく自然言語の入力を理解しますが, 文章は書かず, 利用者が決めた選択肢のどれか (たとえば問い合わせの担当を billing, technical, account から選ぶ) と, その確率を返します. クラスとその確率を返す形は, 本章の分類器と同じです. 値の型が決まっているので, プログラムがその値で分岐でき, 文書は, Jev の答えをコードによる決定的な検査と組み合わせる使い方を挙げています. 同じ文書は, 確率が多数の予測をまとめて見たときの不確かさを反映するよう調整されているが, 個々の答えが正しいことの保証ではないとも述べています.
同社は, 繰り返しの評価で安定した答えを返すことと, 速さ, 低い費用を設計の目標に掲げています (How to build with TypeSafe). 文書に書かれているのは安定を目指す設計であって, 同じ確率値が毎回返るという保証ではありません. 2026 年に公開された新しい製品なので, 仕様や性能は今後変わりえます.
機械学習
これまで, 回帰などの手法によって, データを用いた予測や判別を行ってきました. 本章で学ぶ機械学習も予測や判別を行うための手法です.
例として, 以下の犬と猫の画像について考えてみましょう.
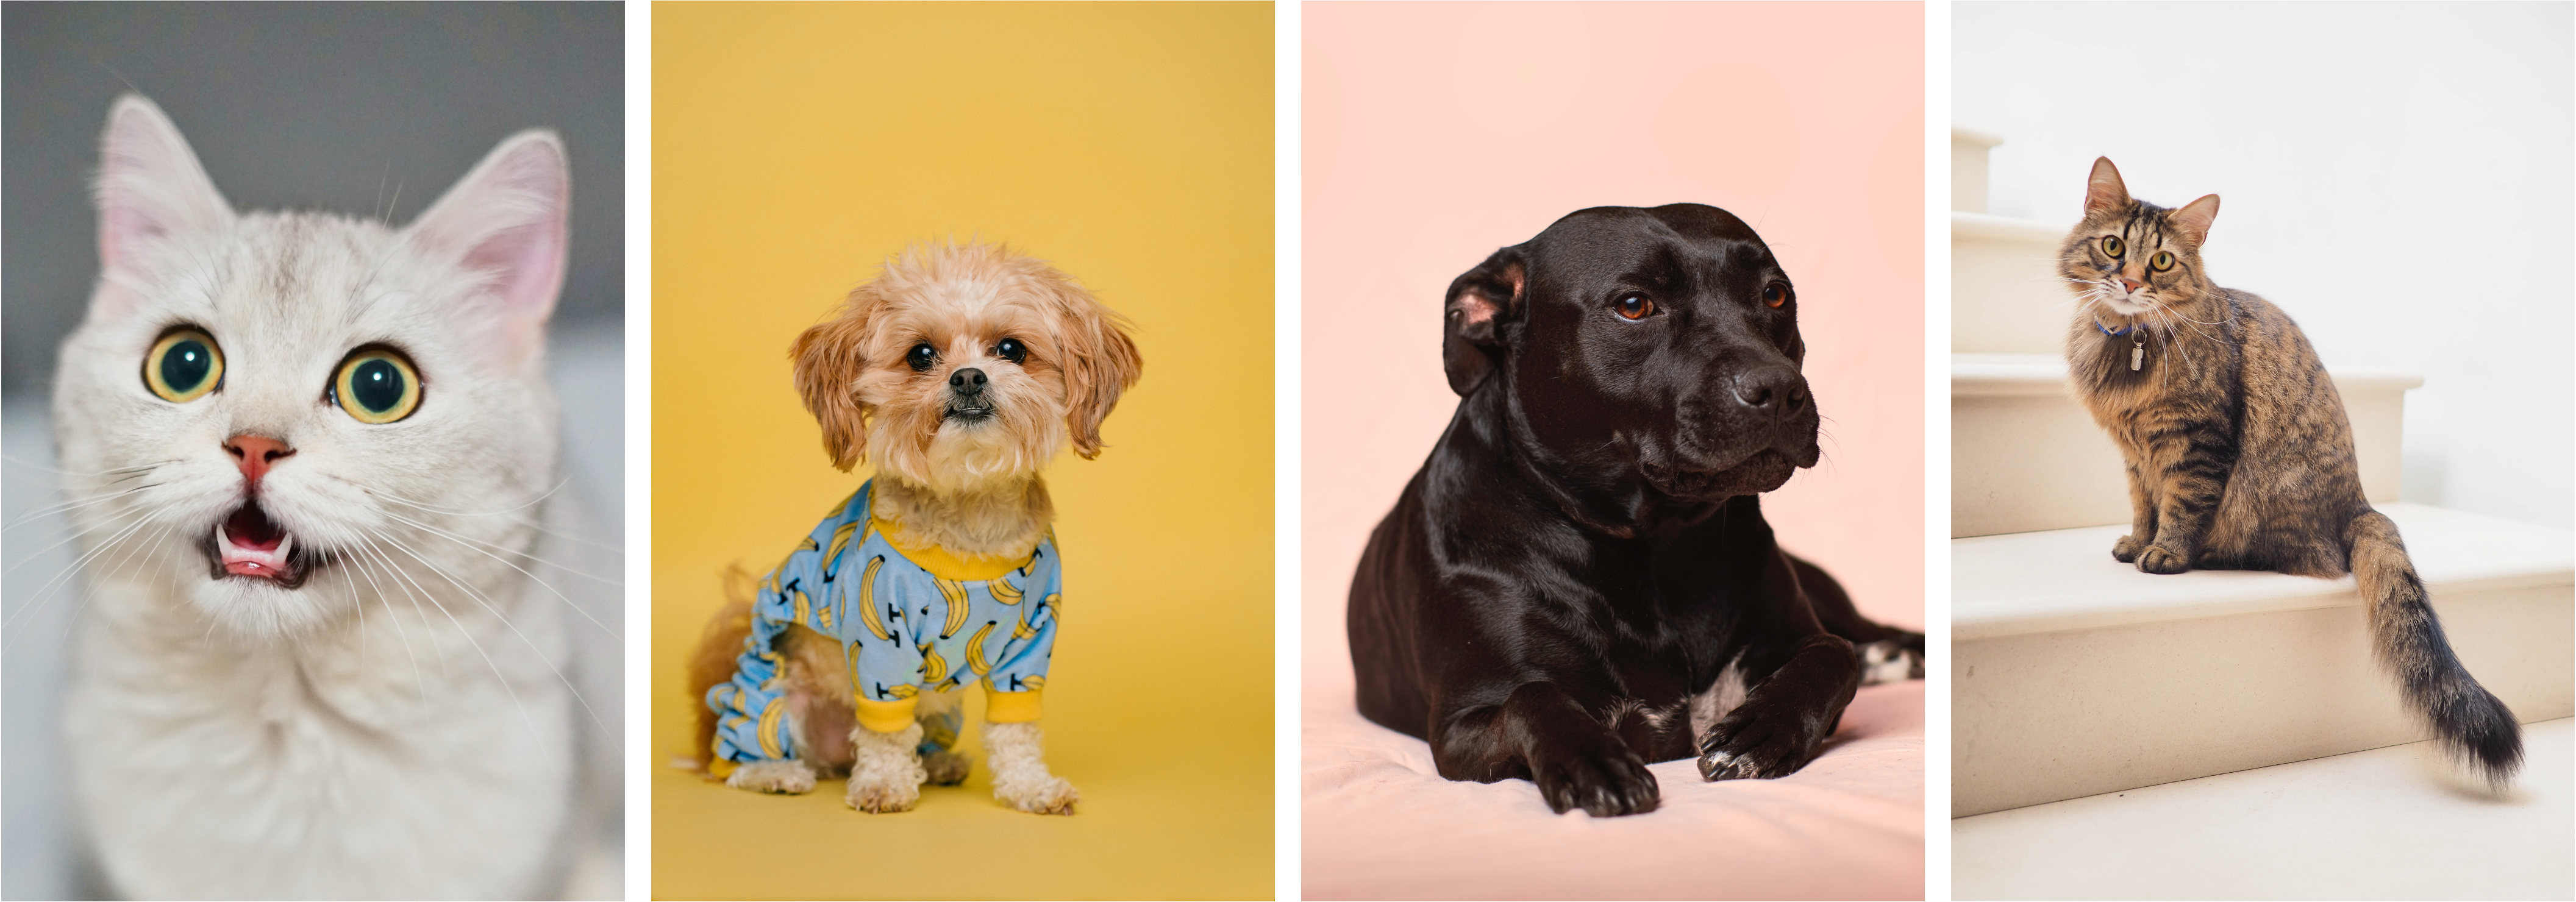
人間であれば, どれが犬でどれが猫であるかを簡単に判別できます. しかし, どのようにして判別しているかを人に説明できるでしょうか?
例えば, 上の画像であれば,
- 猫は鼻が赤く, 犬は黒い
- 猫は耳が立っており, 犬は耳が下がっている
などの違いがあるようにも思えますが, 鼻が黒い猫も, 耳が立っている犬もいます. 初期の AI 開発ではこのようなルールを人間が発見し, プログラムしていました. しかし, 画像から犬と猫を見分けるルールを明確に定義するのはなかなか難しい作業です.
そこで, AI の開発は, 「機械自体が判別のためのルールを発見する」ための学習方法をプログラムする方向に進み始めます. そのような手法全般を機械学習といいます.
機械学習の定義は様々ありますが, 有名なものに以下があります.
“Field of study that gives computers the ability to learn without being explicitly programmed” ((機械学習とは)コンピュータに, 明示的にプログラムされなくても学習する能力を与える学問分野)
Arthur Samuel (1959)
これまでに行ってきた統計学の主な目的は以下のようなものです.
- 記述統計学
- 集めたデータの特徴を代表値やグラフなどを用いて記述する
- 推測統計学
- データを利用してその背景 (母集団) を推測する.
いずれも, 得られたデータの特徴を知ることを目的としています.
一方で機械学習は, 得られたデータを利用して, 要約・予測・判別などの「判断」を機械に行わせることが目的であり, どのようにデータを利用して判断するか自体は機械が自ら学習します.
機械学習には大きく分けて「教師あり学習 (Supervised Learning)」と「教師なし学習 (Unsupervised Learning)」の2種類が存在します.
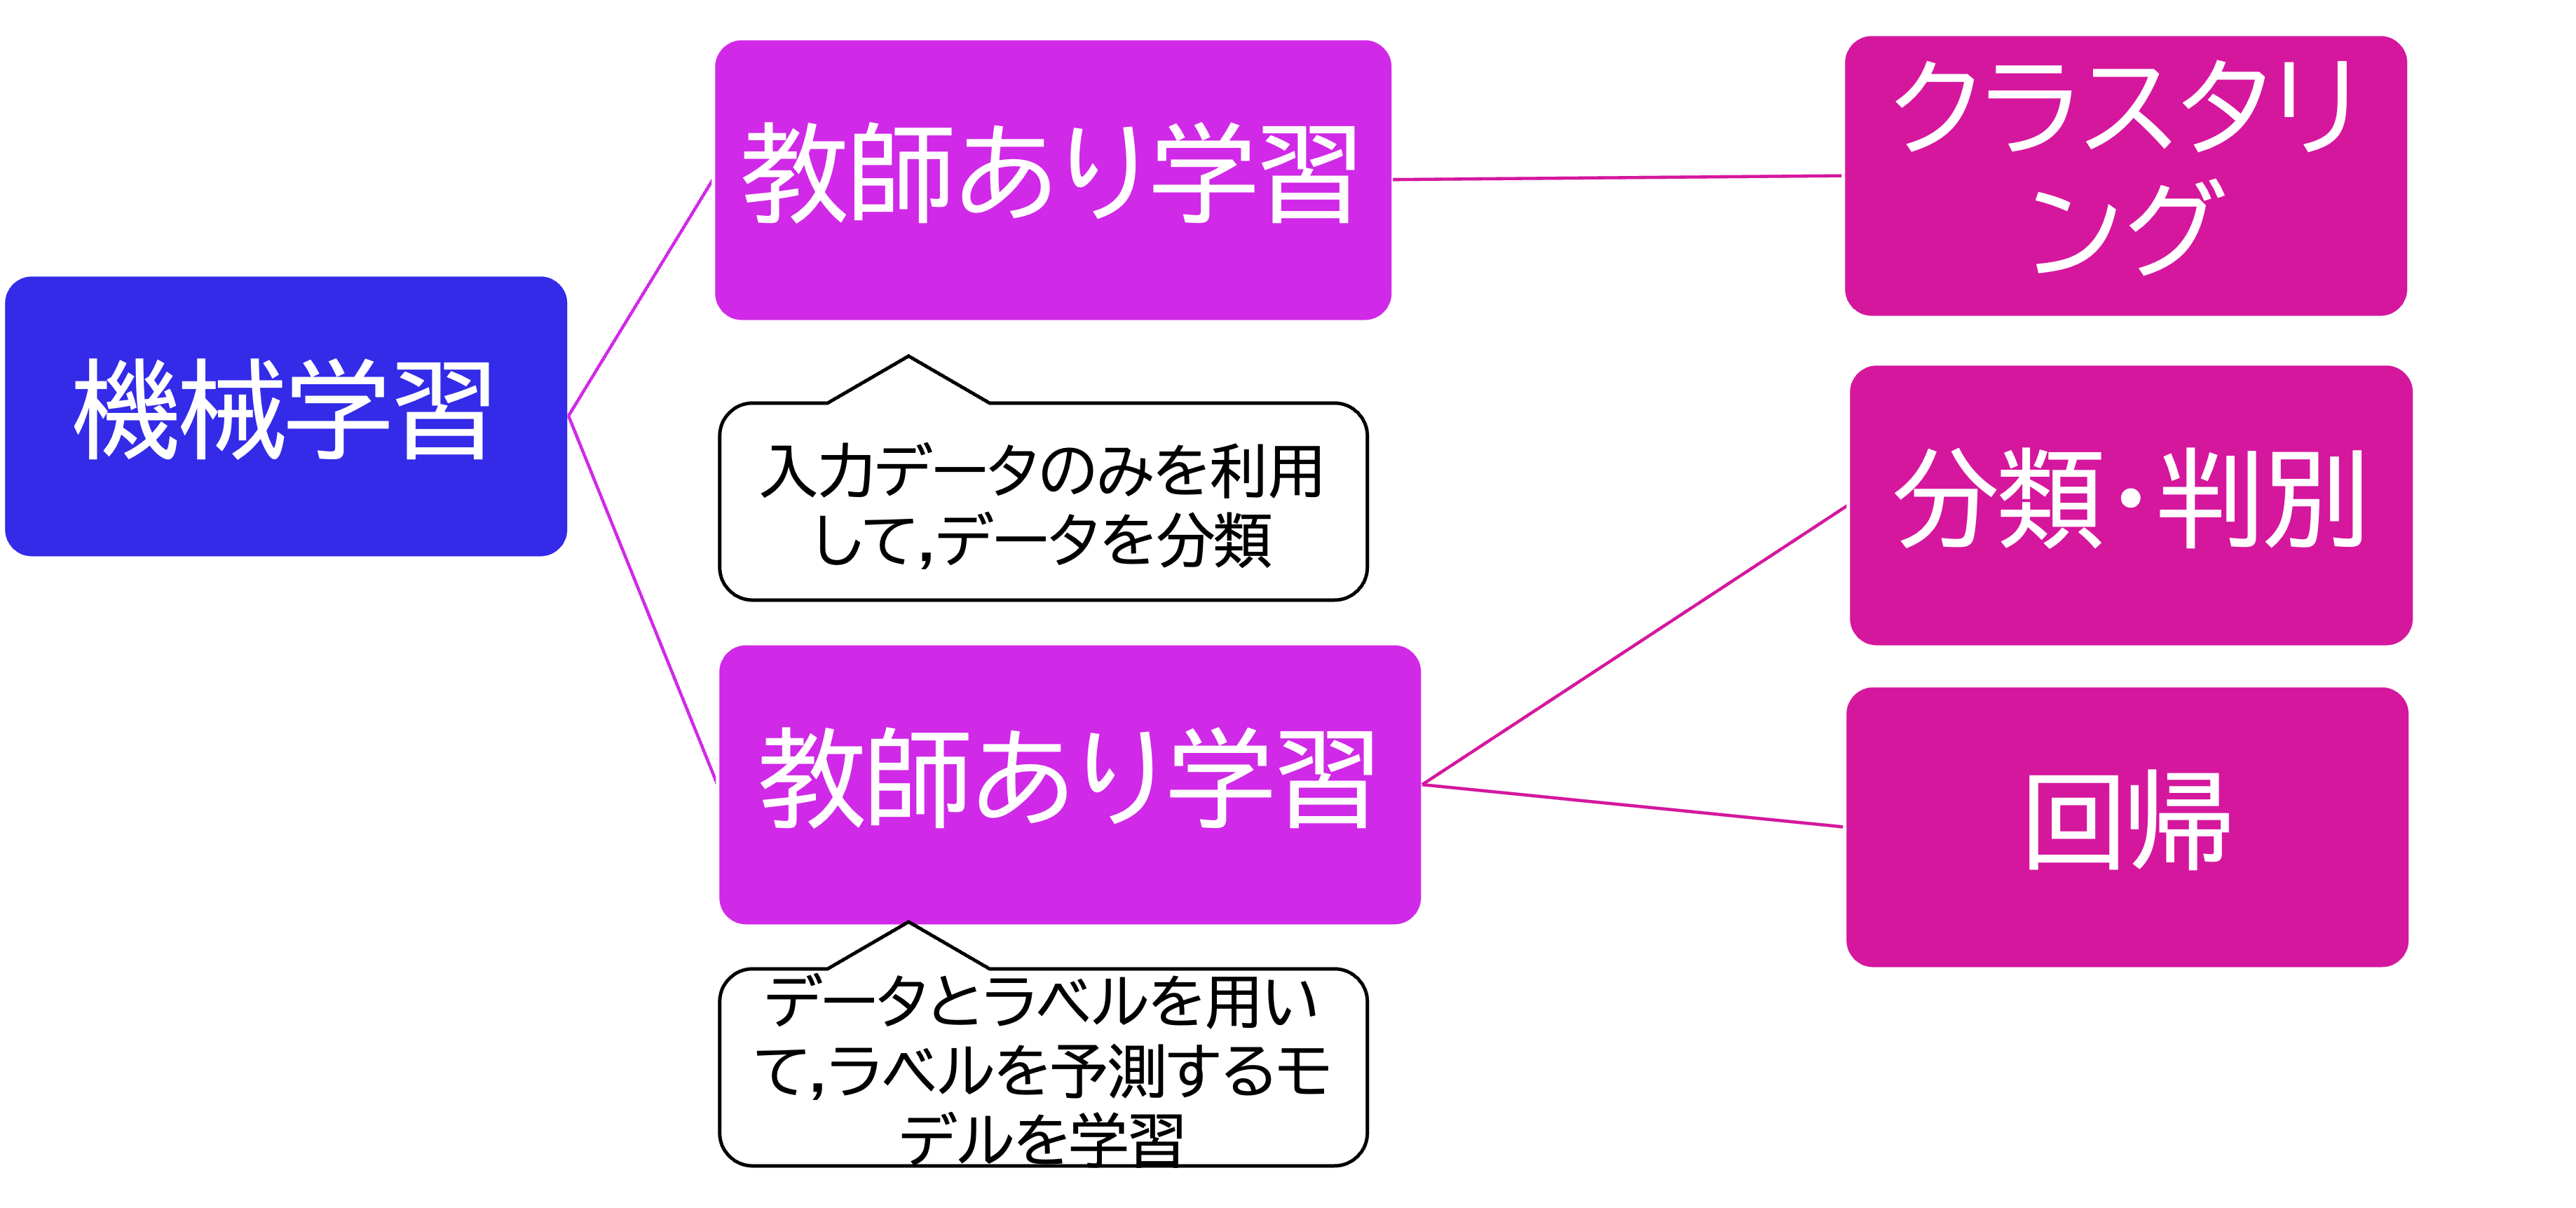
教師あり学習
訓練データ (データと答えのペア) を学習して, 未知のデータから答えを正しく予測する.
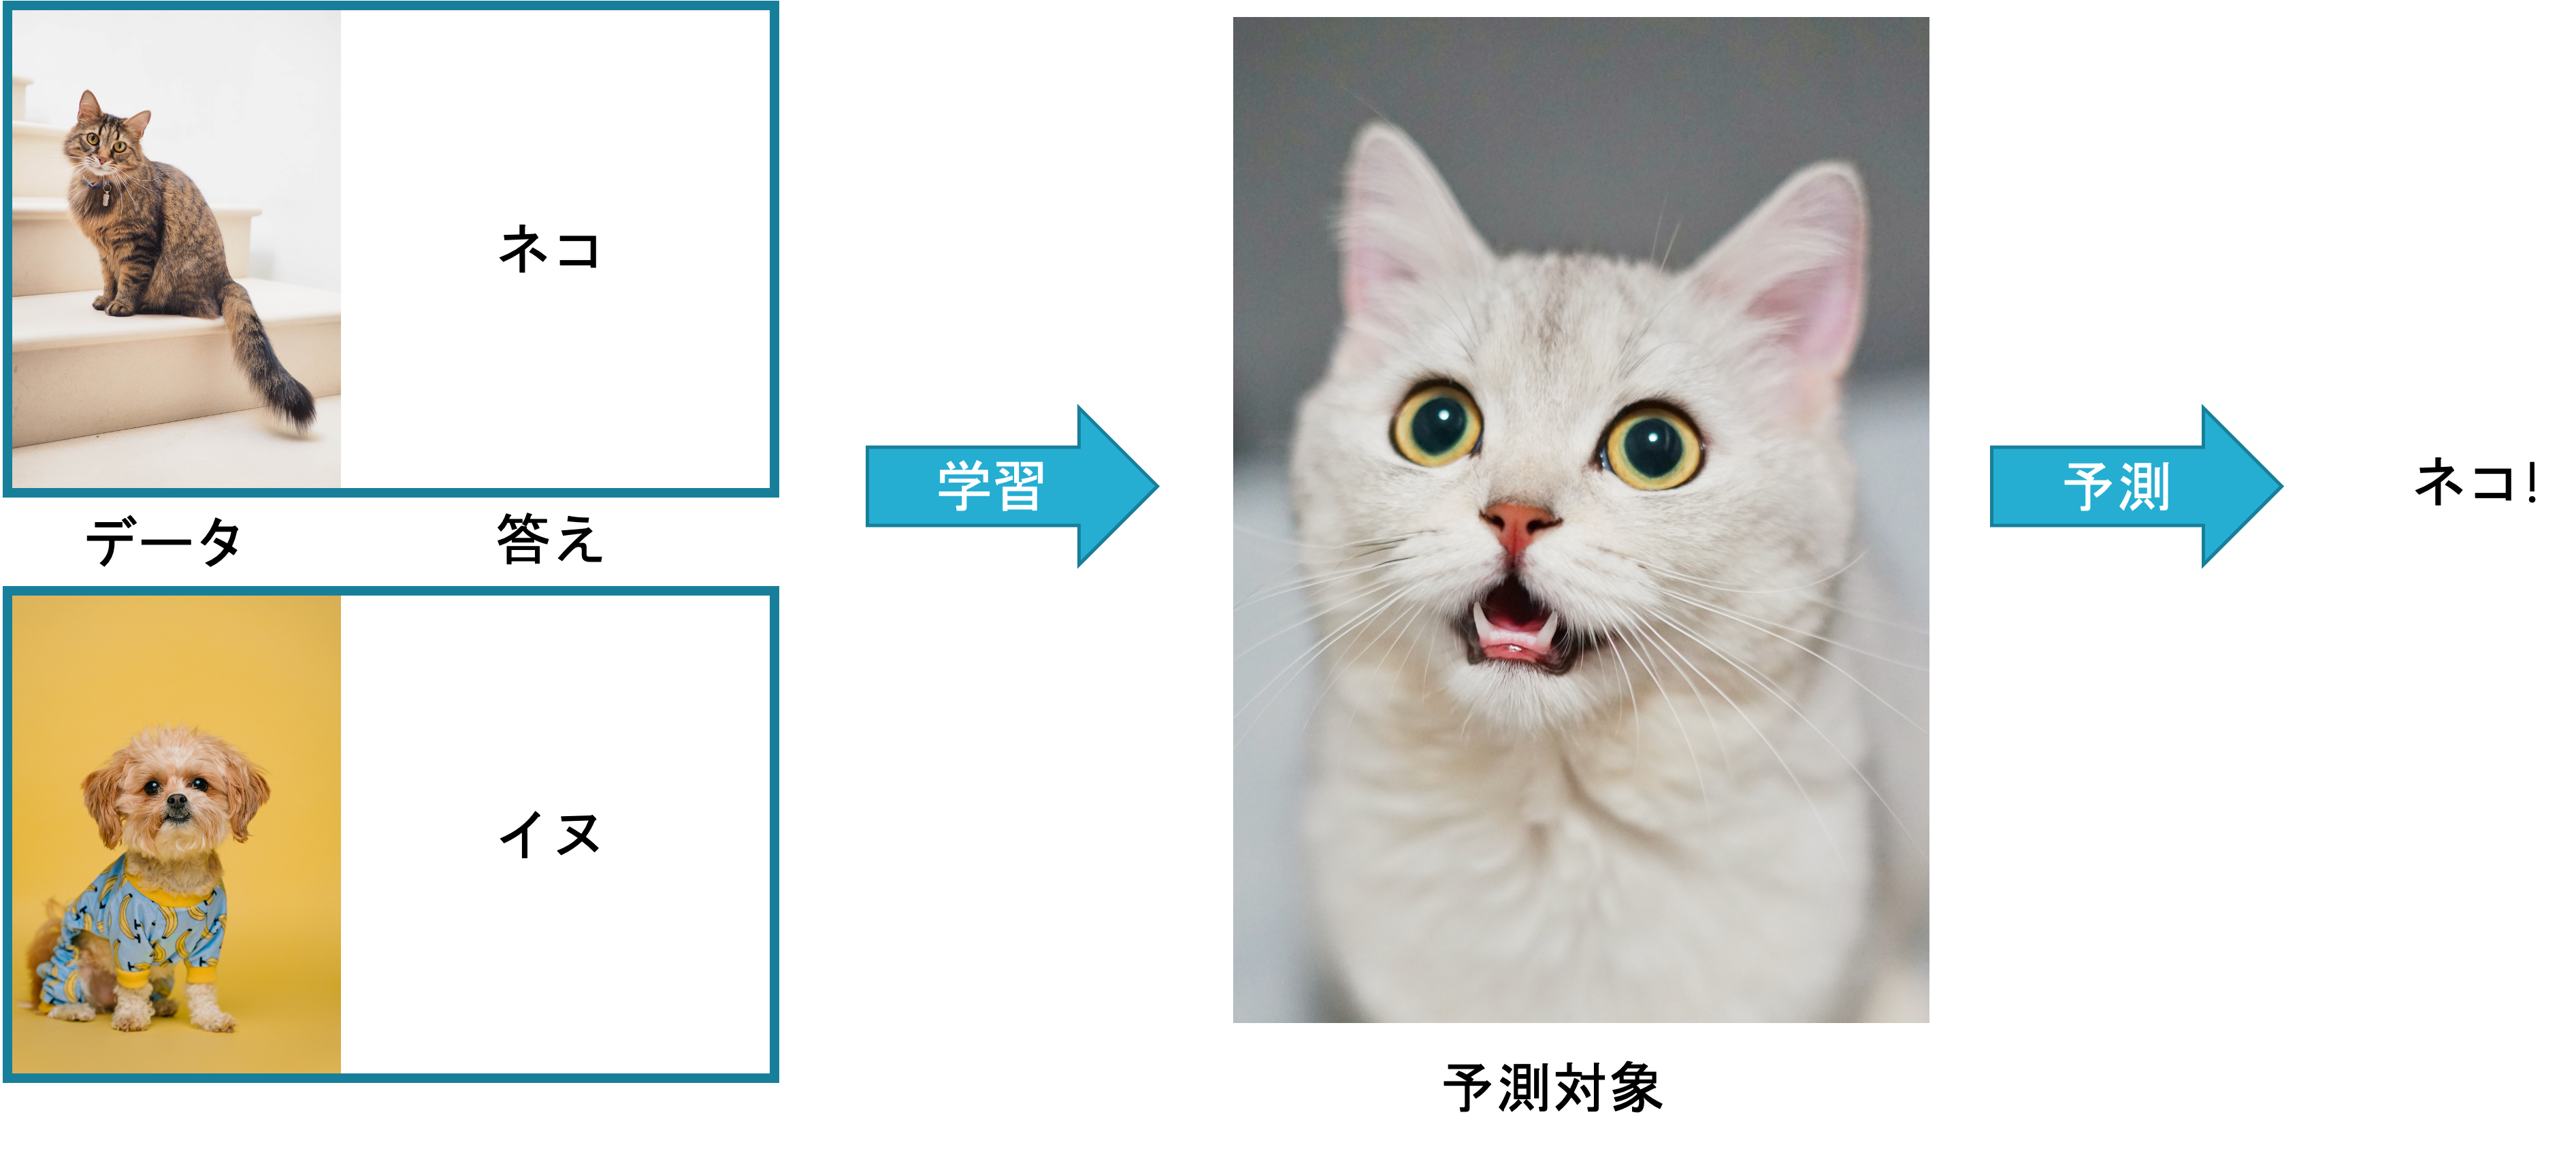
本資料では次のような教師あり学習を扱います.
教師なし学習
データの特徴 (ベクトル) をもとに, 似たものをグループ分け (クラスタリング) します.
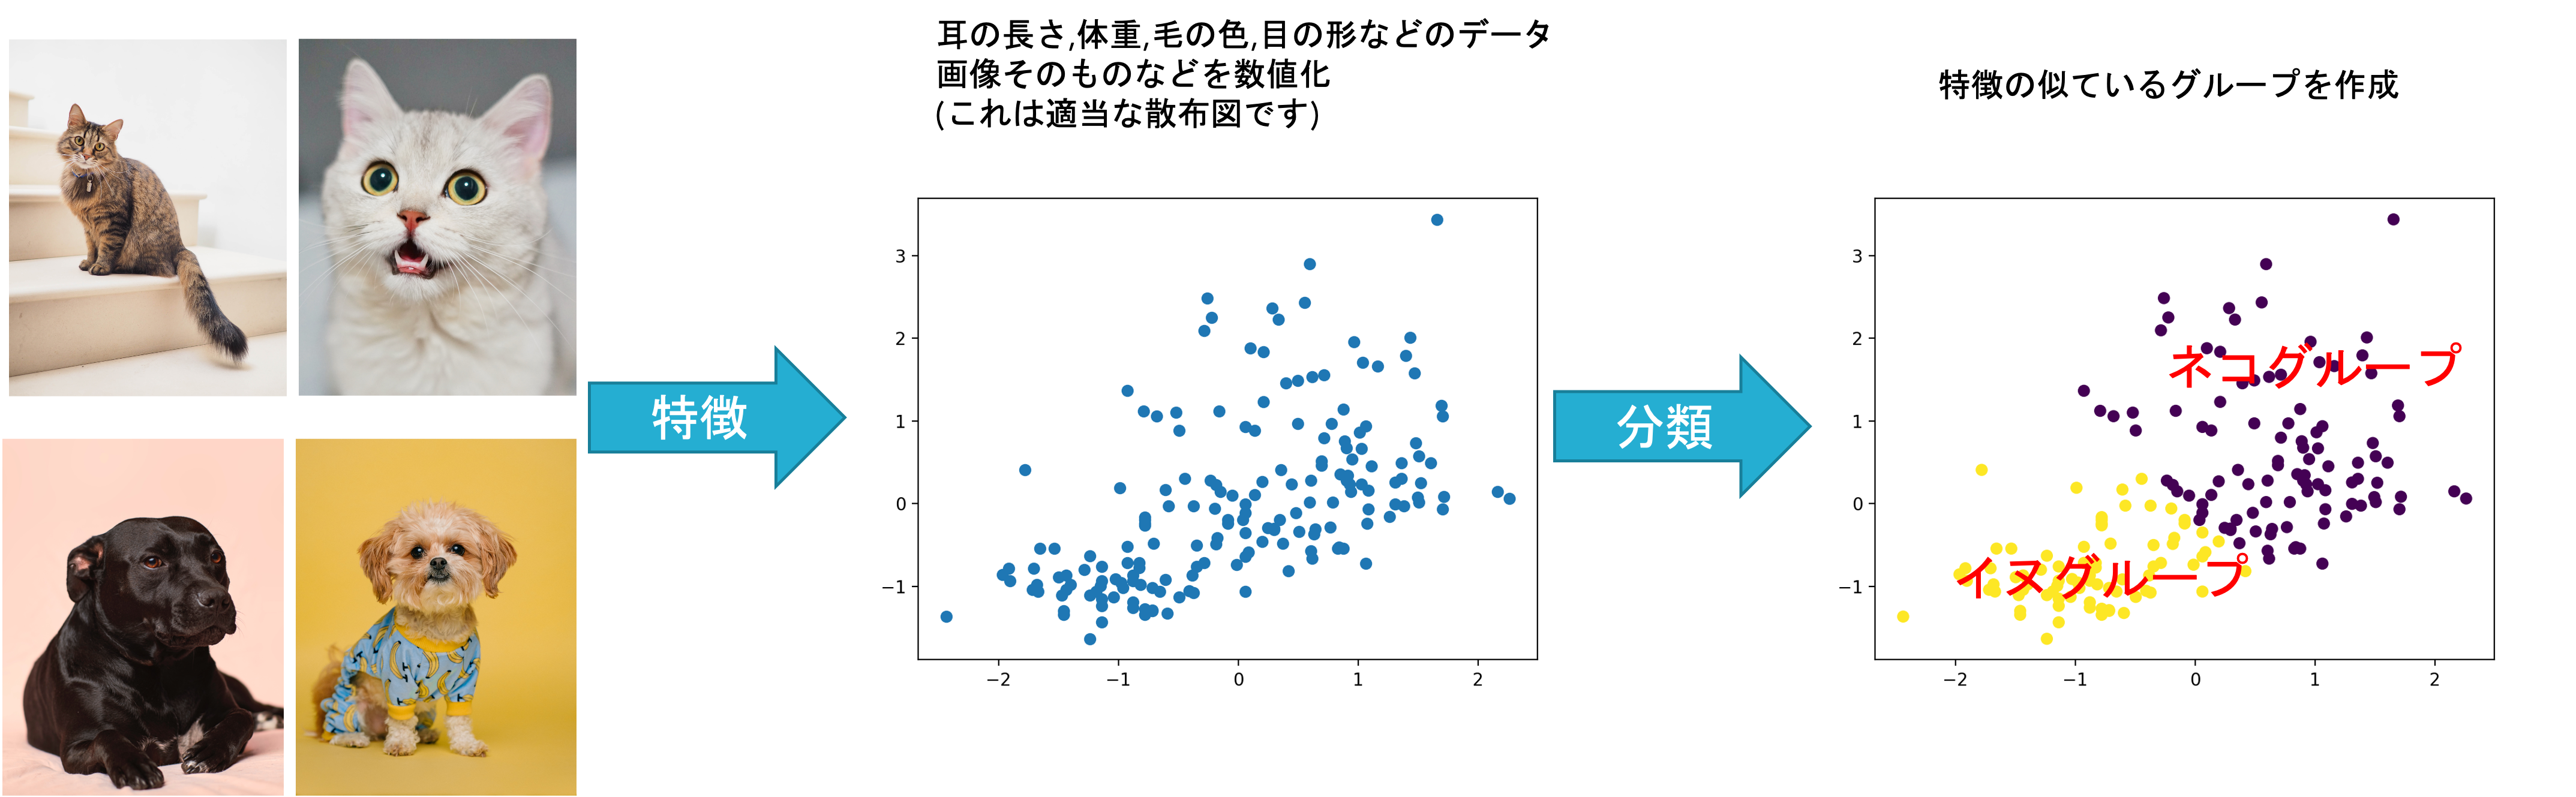
本資料で扱う教師なし学習には, 次のようなものがあります.
教師あり学習
教師あり学習には多くの手法があり, 目的とデータの種類によって使い分けます. 次の図は, 機械学習用のライブラリ scikit-learn の開発者が示している手法の選び方です.
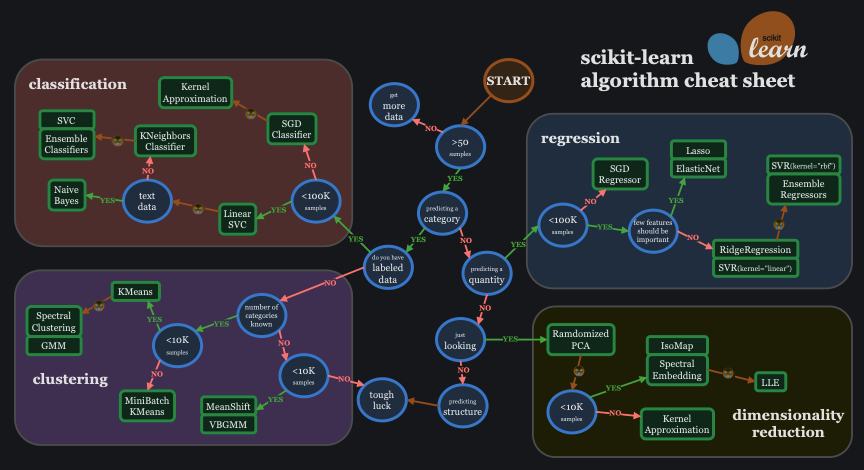 (出典: scikit-learn, Choosing the right estimator). データが 50 件以上あるか, 予測するのがカテゴリか数値か, といった問いに順に答えていくと, 使う手法の候補にたどり着く図です.
本章では次のライブラリを使います. uv add しておいてください (scikit-learn は, import するときには sklearn と書きます).
uv add pandas matplotlib matplotlib-fontja scikit-learn予測技術の活用事例と現象のモデル化
教師あり学習による予測は, 身近なところで多く使われています.
| 分野 | 予測するもの | 予測に使うデータ |
|---|---|---|
| 小売 | 翌週の商品の売れ行き | 過去の売上, 曜日, 天気 |
| 会員サービス | 会員が退会しそうか | 利用の頻度, 最後の利用日 |
| 金融 | 貸したお金が返ってくるか | 収入, 過去の返済の記録 |
| 製造 | 機械が故障しそうか | センサーの値, 稼働時間 |
| メール | 迷惑メールかどうか | 本文の単語, 送信元 |
どの事例も, 予測したい結果 (目的変数) と, 結果に関係しそうな観測できる値 (説明変数) の組を過去のデータから集め, 両者の関係を学習して, 結果がまだ分からない新しいデータに当てはめています. 目的変数が数値なら回帰 (第5章), カテゴリなら分類です.
このように, 複雑な現象を「どの値が結果にどう影響するか」という入力と出力の関係に単純化して表すことを, 現象のモデル化といいます. 会員の退会は, 実際には卒業, 引っ越し, 店の品ぞろえへの不満など多くの事情で起こります. それらをすべて観測することはできないので, 観測できる値 (来店の頻度など) だけで退会のしやすさを表すモデルを作ります. モデルは現象そのものではなく, 目的に必要な部分だけを取り出した近似です. どの値を説明変数に選ぶかは, 分析の目的と, 現象についての知識 (第2章の分析設計) で決まります.
例題のデータ: 売店の会員の退会
こちらのデータは, ある大学の売店の会員 200 人について, 1 学期分 (4 月から 7 月) の購買記録を集計した値と, 翌学期に会員を退会したかどうかをまとめたものです (練習用に作成した架空のデータです). 同じ売店の購買記録は, 第7章でも使います.
| 列 | 内容 |
|---|---|
member_id |
会員番号 |
visits |
来店回数 |
amount_per_visit |
1 回あたりの購入額 (円) |
days_since_last |
最後に来店した日から学期末 (7 月 24 日) までの日数 |
share_meal, share_drink, share_snack, share_stationery |
購入額のうち, 食事, 飲料, 菓子, 文具が占める割合 |
churned |
翌学期に退会したら 1, 続けたら 0 (目的変数) |
import pandas as pd

df = pd.read_csv('data/member_churn.csv', encoding='utf-8-sig')
print(df[['member_id', 'visits', 'amount_per_visit', 'days_since_last', 'churned']].head())
"""
   member_id  visits  amount_per_visit  days_since_last  churned
0       1001      27             468.5                0        0
1       1002      38             438.4                0        0
2       1003      32             451.2                0        0
3       1004      32             415.0                0        0
4       1005      28             440.4                0        0
"""
print(df['churned'].value_counts())
"""
churned
0    126
1     74
"""
200 人のうち 74 人 (37%) が退会しています. 目的変数は churned, 説明変数は会員番号を除く残りの 7 列です.
決定木分析
データの各項目についての「はい/いいえ」の分岐を木の形に重ねて, 目的の値を予測する手法を決定木分析といいます. 目的変数がカテゴリの場合は分類木, 数値の場合は回帰木と呼びます.
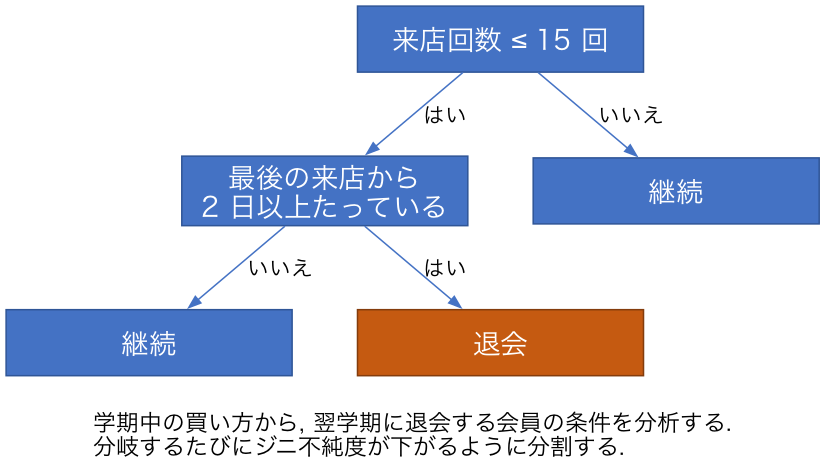
上の図は, この後で売店の会員のデータから学習させる決定木を, 分岐の条件だけ残して描いたものです. 一番上の条件から順に「はい/いいえ」で進み, 行き着いた箱がその会員についての予測になります.
決定木は, 分類の性能では他の手法に劣ることが多いものの, 予測の根拠を図で示せて, 人が読んで理解しやすいという長所があります.
代表的なアルゴリズムに, CART (Classification and Regression Trees) があります. CART は, データを 2 つに分ける分岐を繰り返して木を作ります. 分岐の先にある箱をさらに分けていき, それ以上分けない末端の箱を葉といいます. 分岐の良さは, 分けた後のそれぞれのグループがどれだけ 1 つのクラスに揃っているかで測ります. その尺度がジニ不純度です.
- ジニ不純度 (Gini impurity)
I_G = 1 - \sum_{i=1}^{c} \left( \frac{n_i}{N} \right)^2
c: クラスの数, N: そのグループのデータの数, n_i: そのうちクラス i に属するデータの数.
グループがすべて同じクラスなら I_G = 0 で, 2 クラスが半々のときに最大の 0.5 になります. 例えば, 退会 41 人と継続 3 人の 44 人のグループなら,
I_G = 1 - \left( \frac{41}{44} \right)^2 - \left( \frac{3}{44} \right)^2 \approx 1 - 0.868 - 0.005 = 0.127
となり, ほぼ退会した会員だけのグループであることを表します. CART は, すべての説明変数とすべての分け目の候補について, 分けた後のジニ不純度 (2 つのグループのジニ不純度を人数で重み付けした平均) を計算し, それが最も小さくなる分岐を選びます. 分けたそれぞれのグループで同じことを繰り返し, グループが 1 つのクラスだけになるか, 指定した深さに達するまで木を伸ばします.
scikit-learn の DecisionTreeClassifier で, 退会を予測する決定木を作ります. モデルの性能を確かめるために, データを学習用 (訓練データ) と評価用 (テストデータ) に分けてから学習します (分ける理由は分類の評価で説明します).
import matplotlib.pyplot as plt
import matplotlib_fontja
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier, plot_tree

X = df.drop(columns=['member_id', 'churned'])  # 説明変数
y = df['churned']                              # 目的変数

# 7割を訓練データ, 3割をテストデータにする (退会の割合を両方で揃える)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=0, stratify=y)

# 深さ2までの決定木を学習する
tree = DecisionTreeClassifier(max_depth=2, random_state=0)
tree.fit(X_train, y_train)

# 決定木を図にする
plt.figure(figsize=(12, 6))
plot_tree(tree, feature_names=X.columns, class_names=['継続', '退会'],
          filled=True, impurity=True)
plt.show()
plt.close()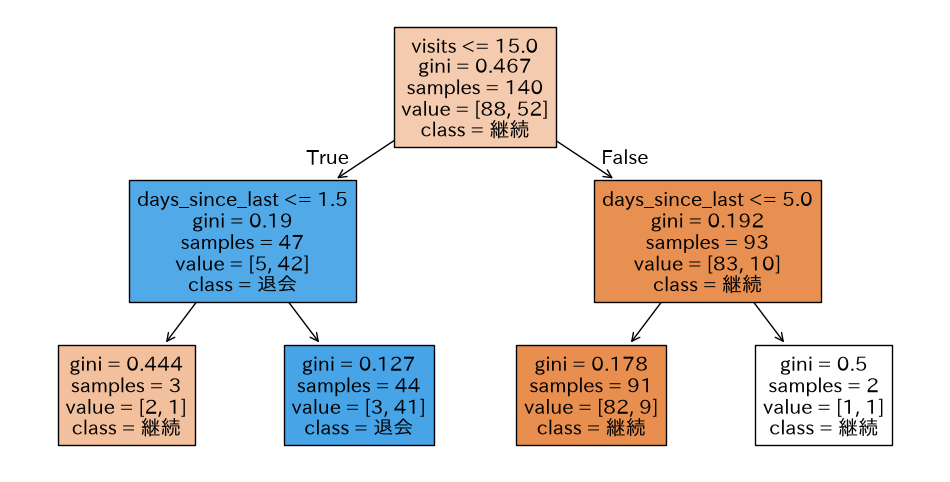
各箱の 1 行目が分岐の条件, gini がジニ不純度, samples がその箱に来た訓練データの人数, value が [継続, 退会] の人数, class が多い方のクラス (その箱に来たデータの予測) です. 条件を満たすデータは左へ, 満たさないデータは右へ進みます.
最初の分岐は来店回数 (visits <= 15) です. 来店回数が 15 回以下の会員 (左) は 47 人中 42 人が退会し, 16 回以上の会員 (右) は 93 人中 83 人が継続しています. 左側はさらに最後の来店からの日数で分かれ, 来店が少なく, 最後の来店から 2 日以上たっている会員は 44 人中 41 人が退会しています. この木からは, 「あまり来ない会員が, 学期末に向けて来なくなると退会しやすい」と読めます. 説明変数はほかに 5 つありますが, 深さ 2 の木ではこの 2 つだけが使われました.
学習したモデルでテストデータの退会を予測し, 正解と比べます.
pred = tree.predict(X_test)  # テストデータの予測 (0 か 1)
print((pred == y_test).mean())  # 正解率
"""
0.8333333333333334
"""
テストデータ 60 人のうち, 83% の会員について退会するかどうかを正しく予測できました.
この節に対応する演習は, 章末のExercise DSP6-1とExercise DSP6-3です.
分類の評価
評価指標の選び方
モデルの予測の良さを測る指標は, 予測する値の種類と, 予測を何に使うかで選びます. 次の図を上からたどって指標を選んでください. 「はい」なら右の指標へ, 「いいえ」なら下の問いへ進みます.
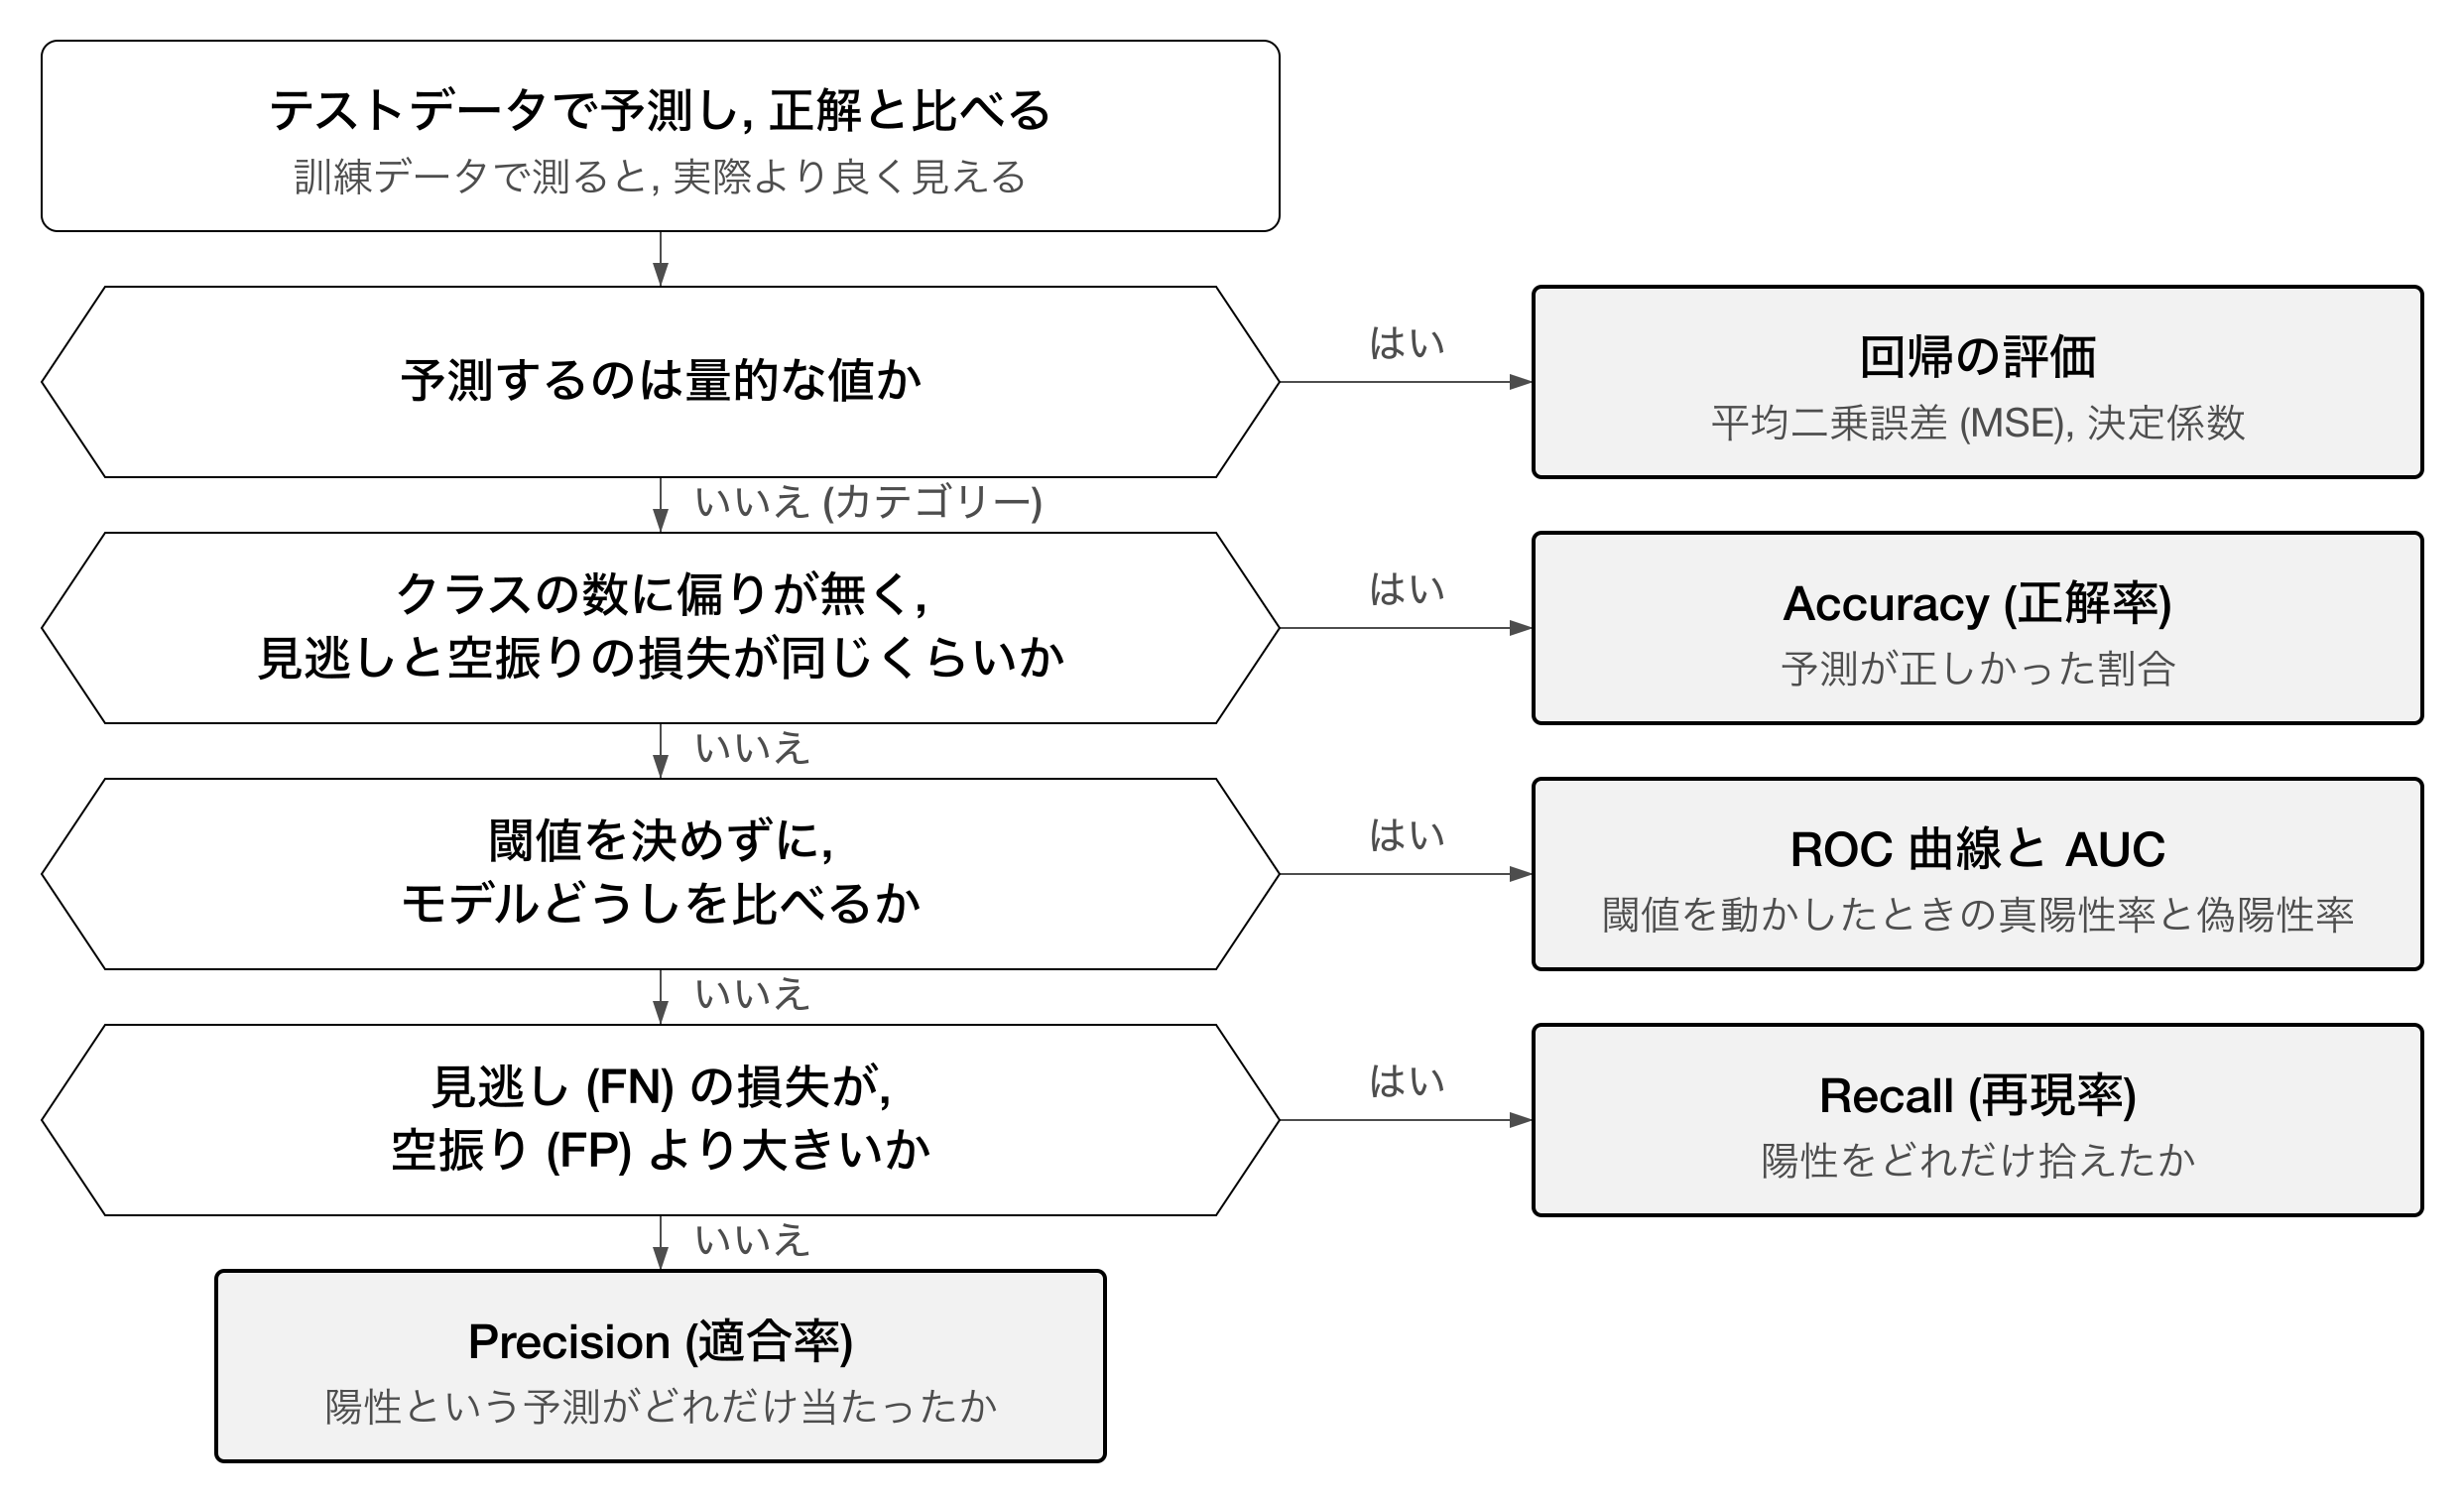
図の各箱は, 次の節で説明します.
- テストデータで予測し, 正解と比べる: 訓練データとテストデータ
- 回帰の評価: 第5章の回帰の評価
- Accuracy, Recall, Precision: Accuracy, Precision, Recall
- ROC 曲線と AUC: ROC 曲線と AUC
分類の指標はどれも, 混同行列の 4 つの数から計算します. 図の FN (見逃し) と FP (空振り) は混同行列のマスの名前で, 閾値は ROC 曲線と AUC で定義します. クラスの数が偏っているときに Accuracy で判断しない理由と, 見逃しと空振りの損失の比べ方は, Accuracy, Precision, Recall で例を使って説明します.
訓練データとテストデータ
モデルの性能を学習に使ったデータで測ると, 実際より良く見えることがあります (第5章の回帰の評価と同じ理由です). 決定木の深さを制限せずに学習させると, この違いを確かめられます.
for depth in [2, None]:  # None は深さを制限しない
    t = DecisionTreeClassifier(max_depth=depth, random_state=0).fit(X_train, y_train)
    print(depth, t.score(X_train, y_train), t.score(X_test, y_test))
"""
2 0.9 0.8333333333333334
None 1.0 0.7833333333333333
"""
深さを制限しない木は, 訓練データを 1 人残らず正しく分類しています (正解率 1.0). しかしテストデータの正解率は 0.78 で, 深さ 2 の木 (0.83) より下がっています. 深い木は, 訓練データにたまたま含まれていた細かい違いまで分岐として覚え込むので, 新しいデータには役立たない分岐が増えます. 訓練データでは性能が高いのに, 新しいデータでは性能が上がらない (あるいは下がる) 状態を過学習といいます.
モデルの目的は, 結果がまだ分からない新しいデータを予測することです. そのため, 学習には使わずに取っておいたテストデータで性能を測ります. train_test_split はデータをランダムに分けるので, random_state で乱数を固定しておくと, 何度実行しても同じ分け方になります.
この節に対応する演習は, 章末のExercise DSP6-1です.
混同行列
正解率だけでは, どんな誤り方をしているかが分かりません. 分類の結果は, 正解と予測の組み合わせごとにデータの数を数えた表で確かめます. この表を混同行列といいます.
見つけたいクラス (ここでは退会) を陽性, もう一方 (継続) を陰性と呼ぶと, 2 クラスの混同行列は次の 4 つのマスからなります.
| 正解 \ 予測 | 陰性 (継続と予測) | 陽性 (退会と予測) |
|---|---|---|
| 陰性 (実際は継続) | TN (真陰性) | FP (偽陽性) |
| 陽性 (実際は退会) | FN (偽陰性) | TP (真陽性) |
T (True) と F (False) は予測が正しいかどうか, P (Positive) と N (Negative) は予測したクラスを表します. 例えば FN は「陰性と予測したが, それは誤りだった」, つまり退会を見逃した会員です.
from sklearn.metrics import confusion_matrix

print(confusion_matrix(y_test, pred))
"""
[[33  5]
 [ 5 17]]
"""
confusion_matrix の出力は上の表と同じ並びで, TN = 33, FP = 5, FN = 5, TP = 17 です. 実際に退会した 22 人のうち 17 人を退会と予測し, 5 人を見逃しました. 継続した 38 人のうち 5 人を, 誤って退会と予測しています.
この節に対応する演習は, 章末のExercise DSP6-2です.
Accuracy, Precision, Recall
混同行列の 4 つの数から, 目的に応じた指標を計算します.
- Accuracy (正解率): 全体のうち, 予測が正しかった割合.
\text{Accuracy} = \frac{TP + TN}{TP + TN + FP + FN}
- Precision (適合率): 陽性と予測したもののうち, 実際に陽性だった割合. 陽性という予測がどれだけ信頼できるかを表す.
\text{Precision} = \frac{TP}{TP + FP}
- Recall (再現率): 実際に陽性だったもののうち, 陽性と予測できた割合. 陽性をどれだけ見逃さずに拾えたかを表す.
\text{Recall} = \frac{TP}{TP + FN}
決定木の予測では, 次のようになります.
- Accuracy: (17 + 33) / 60 \approx 0.833
- Precision: 17 / (17 + 5) \approx 0.773
- Recall: 17 / (17 + 5) \approx 0.773
from sklearn.metrics import accuracy_score, precision_score, recall_score

print(accuracy_score(y_test, pred), precision_score(y_test, pred), recall_score(y_test, pred))
"""
0.8333333333333334 0.7727272727272727 0.7727272727272727
"""
Accuracy だけで判断しない理由は, クラスの数に偏りがあるときに分かります. 例えば, 退会する会員が全体の 5% しかいない店で「全員が継続する」と予測するモデルは, Accuracy が 0.95 になります. しかし退会する会員を 1 人も見つけられないので, Recall は 0 です.
Precision と Recall のどちらを重く見るかは, 予測を何に使うかで決まります. 退会しそうな会員に割引券を送るなら, 見逃し (FN) は会員を失うことに, 空振り (FP) は割引券 1 枚分の費用につながります. 会員を失う損失の方が大きければ, 空振りが増えても Recall を上げたいと考えます. 逆に, 1 件ずつ担当者が電話をかけるような費用の大きい対応なら, Precision を重く見ます.
この節に対応する演習は, 章末のExercise DSP6-2です.
ROC 曲線と AUC
決定木は, 各データについて陽性である確率を出し, その確率が 0.5 を超えるなら陽性と予測しています (ちょうど 0.5 のときは陰性). この 0.5 を閾値といいます. 閾値を下げると陽性と予測する会員が増え, Recall は上がりますが, 空振り (FP) も増えます. 閾値を変えたときのこの関係をまとめて見るのが ROC 曲線です.
- 真陽性率 (TPR, True Positive Rate): Recall と同じ. 実際の陽性のうち, 陽性と予測できた割合.
\text{TPR} = \frac{TP}{TP + FN}
- 偽陽性率 (FPR, False Positive Rate): 実際の陰性のうち, 誤って陽性と予測した割合.
\text{FPR} = \frac{FP}{FP + TN}
閾値を 1 から 0 まで下げていくと, 陽性と予測する会員が増え, TPR と FPR はどちらも 0 から 1 へ増えていきます. 横軸に FPR, 縦軸に TPR をとり, 閾値ごとの点を結んだ曲線を ROC 曲線 (Receiver Operating Characteristic curve) といいます.
from sklearn.metrics import roc_curve, roc_auc_score

prob = tree.predict_proba(X_test)[:, 1]  # 退会である確率
fpr, tpr, thresholds = roc_curve(y_test, prob)
print(roc_auc_score(y_test, prob))
"""
0.8349282296650719
"""

plt.plot(fpr, tpr, marker='o', label='決定木 (深さ 2)')
plt.plot([0, 1], [0, 1], linestyle='--', color='gray', label='ランダムな予測')
plt.xlabel('偽陽性率 (FPR)')
plt.ylabel('真陽性率 (TPR)')
plt.legend()
plt.show()
plt.close()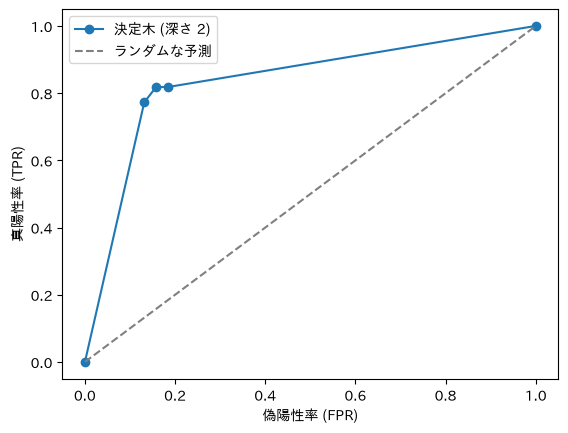
曲線が左上に寄るほど, 空振りを増やさずに陽性を拾えている良いモデルです. 左上の角 (FPR = 0, TPR = 1) は, すべての陽性を空振りなしで拾える完全な予測にあたります. 灰色の対角線は, 確率をでたらめに付けた場合 (どの閾値でも TPR と FPR が等しい) です.
ROC 曲線の下側の面積を AUC (Area Under the Curve) といいます. AUC は 0 から 1 の値をとり, 完全な予測なら 1, でたらめな予測なら 0.5 です. AUC は「退会した会員と継続した会員を 1 人ずつ選んだとき, 退会した会員の方に高い確率を付けている割合」とも解釈できます. 閾値を 1 つに決めなくてもモデルの良さを比べられるのが, AUC の利点です. この決定木の AUC は 0.835 です.
決定木の ROC 曲線は, 数個の点を結んだ折れ線になっています. 決定木が出す確率は, データが最後に行き着いた箱 (葉) の中の退会の割合なので, 深さ 2 の木では 4 通りの値しかとらないためです. 閾値の候補が少ないので, 閾値を細かく調整することはできません.
この節に対応する演習は, 章末のExercise DSP6-3です.
ランダムフォレスト (発展)
ランダムフォレスト, サポートベクターマシン, k 近傍法は, 本文と同じデータと分け方で, 決定木と比べます.
ランダムフォレストは, 少しずつ異なる決定木をたくさん作り, それらの予測を多数決 (確率なら平均) でまとめる手法です. 各木は, 訓練データから重複を許してランダムに選び直したデータで学習し, 分岐のたびに説明変数の一部だけをランダムに候補にします. 1 本の決定木は訓練データの細かい違いに引きずられやすいのですが, 違う誤り方をする木を多数まとめると, 誤りが打ち消し合って予測が安定します.
from sklearn.ensemble import RandomForestClassifier

rf = RandomForestClassifier(n_estimators=200, random_state=0)  # 200本の木
rf.fit(X_train, y_train)
rf_prob = rf.predict_proba(X_test)[:, 1]
print(rf.score(X_test, y_test), roc_auc_score(y_test, rf_prob))
"""
0.8166666666666667 0.8157894736842106
"""
# 説明変数の重要度 (分岐でジニ不純度をどれだけ下げたか)
print(pd.Series(rf.feature_importances_, index=X.columns).sort_values(ascending=False).round(3))
"""
visits              0.246
days_since_last     0.222
share_stationery    0.178
share_meal          0.103
share_drink         0.097
amount_per_visit    0.081
share_snack         0.073
"""
テストデータでの正解率は 0.817, AUC は 0.816 で, 深さ 2 の決定木 (0.833, 0.835) をわずかに下回りました. 説明変数の重要度は, 各変数による分岐がジニ不純度をどれだけ下げたかを, 全部の木で平均した値です. 来店回数と最後の来店からの日数が上位に来ており, 決定木の分岐と一致します. 3 番目の文具の割合は, 文具を中心に買う会員の来店回数が少ないことを反映していると考えられます.
サポートベクターマシン (発展)
サポートベクターマシン (SVM) は, 2 つのクラスを分ける境界を, 境界に最も近いデータ (サポートベクター) からの距離 (マージン) が最大になるように決める手法です. マージンを大きくとると, 新しいデータが境界の近くに来ても分類が揺らぎにくくなります. 直線で分けられないデータには, カーネルと呼ばれる関数でデータを曲がった境界で分けられるようにします (scikit-learn の既定は RBF カーネル). SVM は距離を使うので, 第4章と同じく説明変数を標準化してから使います.
from sklearn.svm import SVC
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import make_pipeline

# 標準化と SVM をつなげて1つのモデルにする
svm = make_pipeline(StandardScaler(), SVC(probability=True, random_state=0))
svm.fit(X_train, y_train)
svm_prob = svm.predict_proba(X_test)[:, 1]
print(svm.score(X_test, y_test), roc_auc_score(y_test, svm_prob))
"""
0.8 0.8110047846889952
"""
make_pipeline は, 標準化 (StandardScaler) と SVM を順につなげて 1 つのモデルとして扱う関数です. 標準化の平均と標準偏差は訓練データから計算され, テストデータにも同じ値が使われます.
3 つのモデルの ROC 曲線を重ねて比べます.
for name, p in [('決定木 (深さ 2)', prob), ('ランダムフォレスト', rf_prob), ('SVM', svm_prob)]:
    f, t, _ = roc_curve(y_test, p)
    plt.plot(f, t, label=f'{name} (AUC = {roc_auc_score(y_test, p):.3f})')
plt.plot([0, 1], [0, 1], linestyle='--', color='gray')
plt.xlabel('偽陽性率 (FPR)')
plt.ylabel('真陽性率 (TPR)')
plt.legend()
plt.show()
plt.close()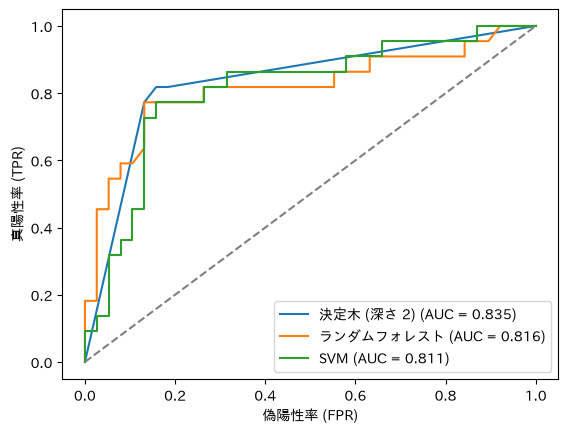
ランダムフォレストと SVM は, 会員ごとに細かく異なる確率を出すので, ROC 曲線が多くの点を通る細かい階段になります. 閾値を細かく調整したいときは, こうしたモデルが使いやすくなります.
一方で, このデータでは AUC は決定木が最も高く, ランダムフォレスト (0.816) と SVM (0.811) は少し下回りました. このデータの退会は, 来店回数と最後の来店からの日数という 2 つの変数の単純な条件でほぼ決まっているので, 深さ 2 の決定木でも十分に表せたと考えられます. 複雑な手法がいつも良い結果を出すとは限りません. また, テストデータは 60 人しかいないので, AUC の 0.02 程度の差は, データの分け方 (random_state) を変えると入れ替わりうる大きさです. 手法を比べるときは, 分け方を変えて何度か評価し, 差が安定しているかも確かめます.
k 近傍法 (発展)
k 近傍法 (k-NN, k-Nearest Neighbor) は, 予測したい会員に説明変数の値が近い会員を訓練データから k 人選び, その k 人の多数決でクラスを決める手法です. 退会の確率は, k 人のうち退会した人の割合になります. 学習の段階では訓練データを覚えておくだけで, 計算は予測のときに行います. SVM と同じく距離を使うので, 説明変数を標準化してから使います.
k を 1 から 21 まで変えて, 訓練データとテストデータでの正解率を比べます.
from sklearn.neighbors import KNeighborsClassifier

ks = range(1, 22, 2)  # k = 1, 3, 5, ..., 21
train_acc, test_acc = [], []
for k in ks:
    knn = make_pipeline(StandardScaler(), KNeighborsClassifier(n_neighbors=k))
    knn.fit(X_train, y_train)
    train_acc.append(knn.score(X_train, y_train))
    test_acc.append(knn.score(X_test, y_test))

fig, ax = plt.subplots()
ax.plot(ks, train_acc, marker='o', label='訓練データ')
ax.plot(ks, test_acc, marker='o', label='テストデータ')
ax.set_xlabel('近傍の数 k')
ax.set_ylabel('正解率')
ax.set_xticks(list(ks))
ax.legend()
plt.show()
plt.close(fig)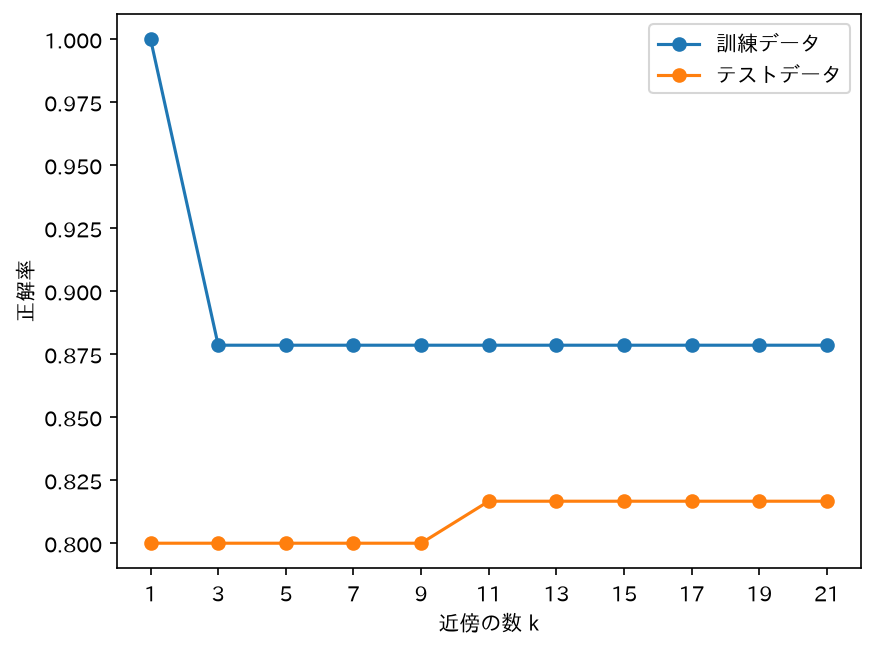
k = 1 では訓練データの正解率が 1.000 になります. 訓練データの会員にとって最も近い会員は自分自身なので, 必ず正解するためです. 一方でテストデータの正解率は 0.800 にとどまります. k を 11 以上にすると, 訓練データの正解率は 0.879 に下がり, テストデータの正解率は 0.817 に上がります. k が小さいほど訓練データの 1 人ずつに合わせた予測になり, 訓練データとテストデータで説明した過学習が起きます. k = 15 のときの AUC は 0.849 です.
標準化が要ることも確かめます. 標準化せずに k = 15 で学習すると, テストデータの正解率は 0.767 で, 標準化したとき (0.817) より下がります. 標準化しないと, 値の幅が大きい来店回数や 1 回あたりの購入額が距離の大半を占め, 購入額の割合の違いがほとんど距離に表れないためです.
knn_raw = KNeighborsClassifier(n_neighbors=15)  # 標準化しない
knn_raw.fit(X_train, y_train)
print(knn_raw.score(X_test, y_test))
"""
0.7666666666666667
"""
過学習の様子は, 説明変数を来店回数と最後の来店からの日数の 2 つに絞ると図で見られます. 次の図は, k = 1 と k = 15 のそれぞれについて, 平面上の各点で k 近傍法が予測するクラスを色で塗り, 訓練データの会員を点で重ねたものです.
import numpy as np

cols = ['visits', 'days_since_last']
# 図を塗るための格子点 (来店回数 0〜75 回, 日数 0〜85 日)
gx, gy = np.meshgrid(np.linspace(0, 75, 300), np.linspace(0, 85, 300))
grid = pd.DataFrame({'visits': gx.ravel(), 'days_since_last': gy.ravel()})

fig, axes = plt.subplots(1, 2, figsize=(12, 5), sharey=True)
for ax, k in zip(axes, [1, 15]):
    model = make_pipeline(StandardScaler(), KNeighborsClassifier(n_neighbors=k))
    model.fit(X_train[cols], y_train)
    pred = model.predict(grid).reshape(gx.shape)
    ax.contourf(gx, gy, pred, levels=[-0.5, 0.5, 1.5], colors=['#cfe0f3', '#f6d2c4'])
    for v, color, label in [(0, '#1f5fa8', '継続'), (1, '#c4462a', '退会')]:
        d = X_train[y_train == v]
        ax.scatter(d['visits'], d['days_since_last'], s=18, color=color, label=label)
    acc = model.score(X_test[cols], y_test)
    ax.set_title(f'k = {k} (テストデータの正解率 {acc:.3f})')
    ax.set_xlabel('来店回数')
axes[0].set_ylabel('最後の来店からの日数')
axes[0].legend()
plt.show()
plt.close(fig)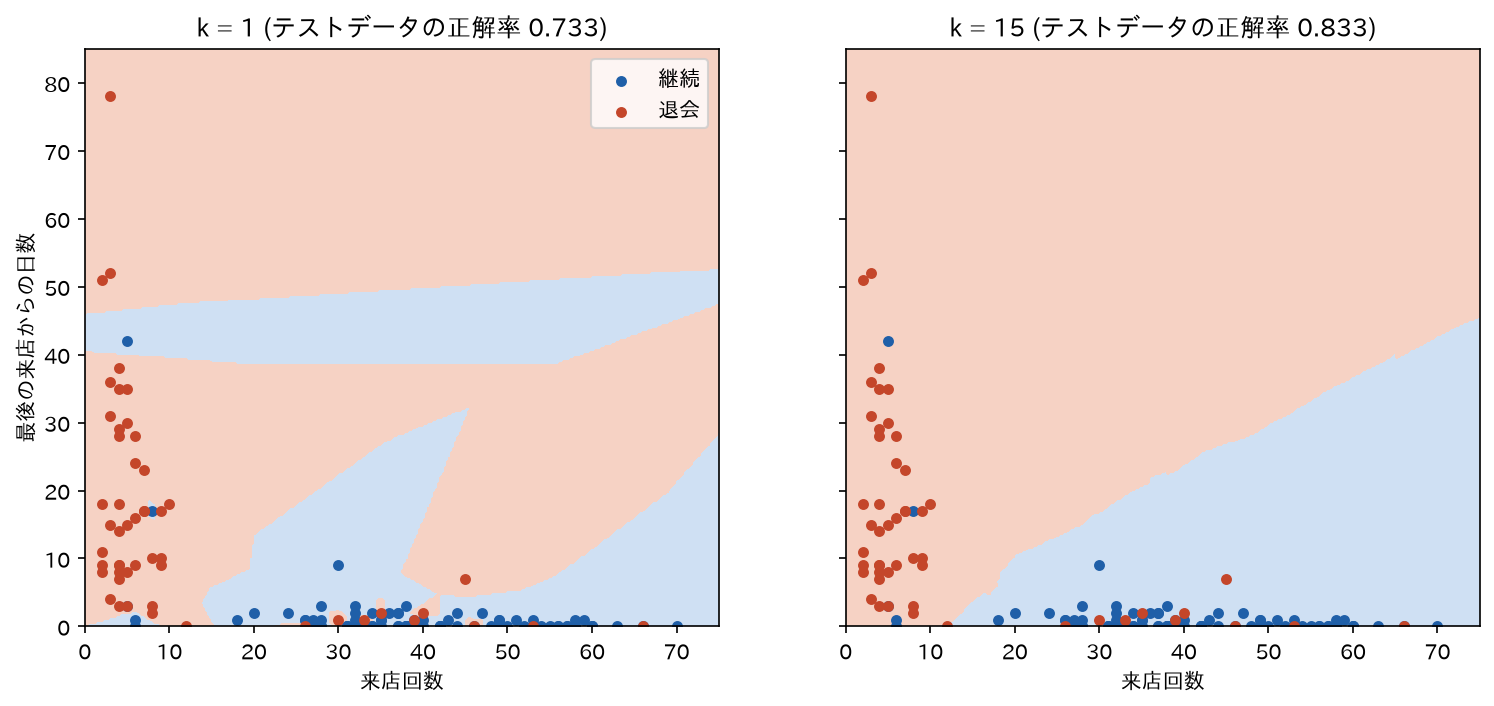
青の領域は継続, 赤の領域は退会と予測される範囲です. k = 1 では, 来店回数が多いのに退会した数人の会員のまわりにも赤の領域ができ, 境界が入り組んでいます. 訓練データの 1 人ずつに合わせた境界なので, テストデータの正解率は 0.733 にとどまります. k = 15 では境界がなめらかになり, 「来店回数が少ないか, しばらく来店していない会員は退会する」という, 決定木の分岐と同じ傾向が表れます. テストデータの正解率も 0.833 に上がります.
演習
Exercise DSP6-1
決定木の深さと過学習
対応する節: 決定木分析, 訓練データとテストデータ
本文のデータと分け方 (test_size=0.3, random_state=0, stratify=y) で, 決定木の深さ max_depth を 1 から 8 まで変えて学習し, 訓練データとテストデータでの正解率を求めて折れ線グラフにしてください. グラフから, 過学習が起き始める深さを読み取ってください.
提出ファイル名: dsp6-1.py
回答例
import pandas as pd
import matplotlib.pyplot as plt
import matplotlib_fontja
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier

df = pd.read_csv('data/member_churn.csv', encoding='utf-8-sig')
X = df.drop(columns=['member_id', 'churned'])
y = df['churned']
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=0, stratify=y)

depths = range(1, 9)
train_acc, test_acc = [], []
for d in depths:
    t = DecisionTreeClassifier(max_depth=d, random_state=0).fit(X_train, y_train)
    train_acc.append(t.score(X_train, y_train))
    test_acc.append(t.score(X_test, y_test))
    print(d, round(train_acc[-1], 3), round(test_acc[-1], 3))

plt.plot(depths, train_acc, marker='o', label='訓練データ')
plt.plot(depths, test_acc, marker='o', label='テストデータ')
plt.xlabel('決定木の深さ')
plt.ylabel('正解率')
plt.legend()
plt.show()
plt.close()
1 0.893 0.817
2 0.9 0.833
3 0.914 0.833
4 0.943 0.817
5 0.95 0.817
6 0.979 0.783
7 0.986 0.783
8 0.993 0.767訓練データの正解率は深さとともに上がり続けますが, テストデータの正解率は深さ 2 と 3 で最大 (0.833) になり, 深さ 4 から下がり始めます. 深さ 4 以降は, 訓練データにだけ当てはまる分岐を増やす過学習が起きています.
Exercise DSP6-2
閾値を下げたときの Precision と Recall
対応する節: 混同行列, Accuracy, Precision, Recall
本文の深さ 2 の決定木について, 退会と予測する閾値を「0.5 を超える」(predict の既定) から「0.3 以上」に下げると, 混同行列, Precision, Recall はどう変わるかを求めてください. 退会しそうな会員に割引券を送る目的では, どちらの閾値が望ましいかを, 理由とともに答えてください.
ヒント: tree.predict_proba(X_test)[:, 1] >= 0.3 で, 閾値 0.3 での予測 (True/False) が得られます.
提出ファイル名: dsp6-2.py
回答例
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import confusion_matrix, accuracy_score, precision_score, recall_score, roc_auc_score

df = pd.read_csv('data/member_churn.csv', encoding='utf-8-sig')
X = df.drop(columns=['member_id', 'churned'])
y = df['churned']
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=0, stratify=y)

tree = DecisionTreeClassifier(max_depth=2, random_state=0).fit(X_train, y_train)
prob = tree.predict_proba(X_test)[:, 1]

for name, pred in [('0.5 を超える', tree.predict(X_test)), ('0.3 以上', (prob >= 0.3).astype(int))]:
    print(name)
    print(confusion_matrix(y_test, pred))
    print(precision_score(y_test, pred), recall_score(y_test, pred))
0.5 を超える
[[33 5]
[ 5 17]]
0.7727272727272727 0.7727272727272727
0.3 以上
[[31 7]
[ 4 18]]
0.72 0.8181818181818182閾値を 0.3 に下げると, 退会と予測する会員が 22 人から 25 人に増えます. 見逃し (FN) が 5 人から 4 人に減って Recall は 0.773 から 0.818 に上がり, 空振り (FP) が 5 人から 7 人に増えて Precision は 0.773 から 0.720 に下がります. 割引券を送る目的では, 退会する会員を 1 人失う損失が割引券 2 枚分の費用より大きいなら, 閾値 0.3 の方が望ましいと言えます. どちらが良いかは, 見逃しと空振りの損失の大きさを比べて決めます.
Exercise DSP6-3
説明変数を絞った決定木
対応する節: 決定木分析, ROC 曲線と AUC
来店回数 (visits) と最後の来店からの日数 (days_since_last) の 2 つだけを説明変数にして, 深さ 2 の決定木を学習してください. テストデータでの Accuracy, Precision, Recall, AUC を求め, 7 つの説明変数を使った本文の木と比べて, 何が言えるかを答えてください.
提出ファイル名: dsp6-3.py
回答例
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import confusion_matrix, accuracy_score, precision_score, recall_score, roc_auc_score

df = pd.read_csv('data/member_churn.csv', encoding='utf-8-sig')
X = df.drop(columns=['member_id', 'churned'])
y = df['churned']
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=0, stratify=y)

X2 = X[['visits', 'days_since_last']]
t2 = DecisionTreeClassifier(max_depth=2, random_state=0)
t2.fit(X2.loc[X_train.index], y_train)
pred2 = t2.predict(X2.loc[X_test.index])
prob2 = t2.predict_proba(X2.loc[X_test.index])[:, 1]
print(accuracy_score(y_test, pred2), precision_score(y_test, pred2),
      recall_score(y_test, pred2), roc_auc_score(y_test, prob2))
0.8333333333333334 0.7727272727272727 0.7727272727272727 0.83492822966507194 つの指標は, 7 つの説明変数を使った本文の木とすべて同じです. 本文の深さ 2 の木も, 分岐に使ったのは来店回数と最後の来店からの日数の 2 つだけだったので, 同じ木ができています. このデータでは, 退会の予測に必要な情報はこの 2 つの変数にほぼ含まれています. 説明変数が少ないモデルは, 予測の根拠を説明しやすく, 集めるデータも少なくて済むので, 性能が同じなら少ない方を選ぶのが一般的です.